
目次
補助金は、情報さえたくさん集めれば見落とさないと思っていた
製造業の中小企業が、設備の更新や省力化への投資を考えるとき、「使える補助金はないか」と探す場面はよくあります。
補助金や助成金の情報は、省庁・自治体・支援機関のサイトや、各種のメルマガに散らばっています。
経済産業省・中小企業庁のミラサポplusや、中小機構のJ-NET21といったポータルもありますが、それでも情報源は一つにまとまりません。
そこで採られがちなのが、担当者にこれらを巡回させ、とにかく情報を「集める」というやり方です。
購読するメルマガを増やし、ブックマークするポータルを増やし、集めた情報をExcelやメモにためていきます。
「情報さえたくさん集めれば、使える補助金を見落とすことはない」。
そう考えたくなります。
ところが実際には、集めるほど手元の情報は増えるのに、自社が使えるものにたどり着けず取りこぼしてしまう、という事態が起こります。
情報は「あるのに拾えていない」状態です。
「補助金情報の自動収集なんて、SIerに発注する大がかりな開発案件だろう」と感じる方もいるかもしれません。
しかし本当の壁は、集める仕組みの大きさではなく、別のところにあります。
カギは“集めること”ではなく、SIerを挟まず月数千円台で自社が回す“一次選別”
先に結論をお伝えします。
補助金の取りこぼしを防ぐカギは、情報を「もっと集めること」ではありません。
集めた大量の公募から、「自社が対象になりそうか」を選び分ける“一次選別”にあります。
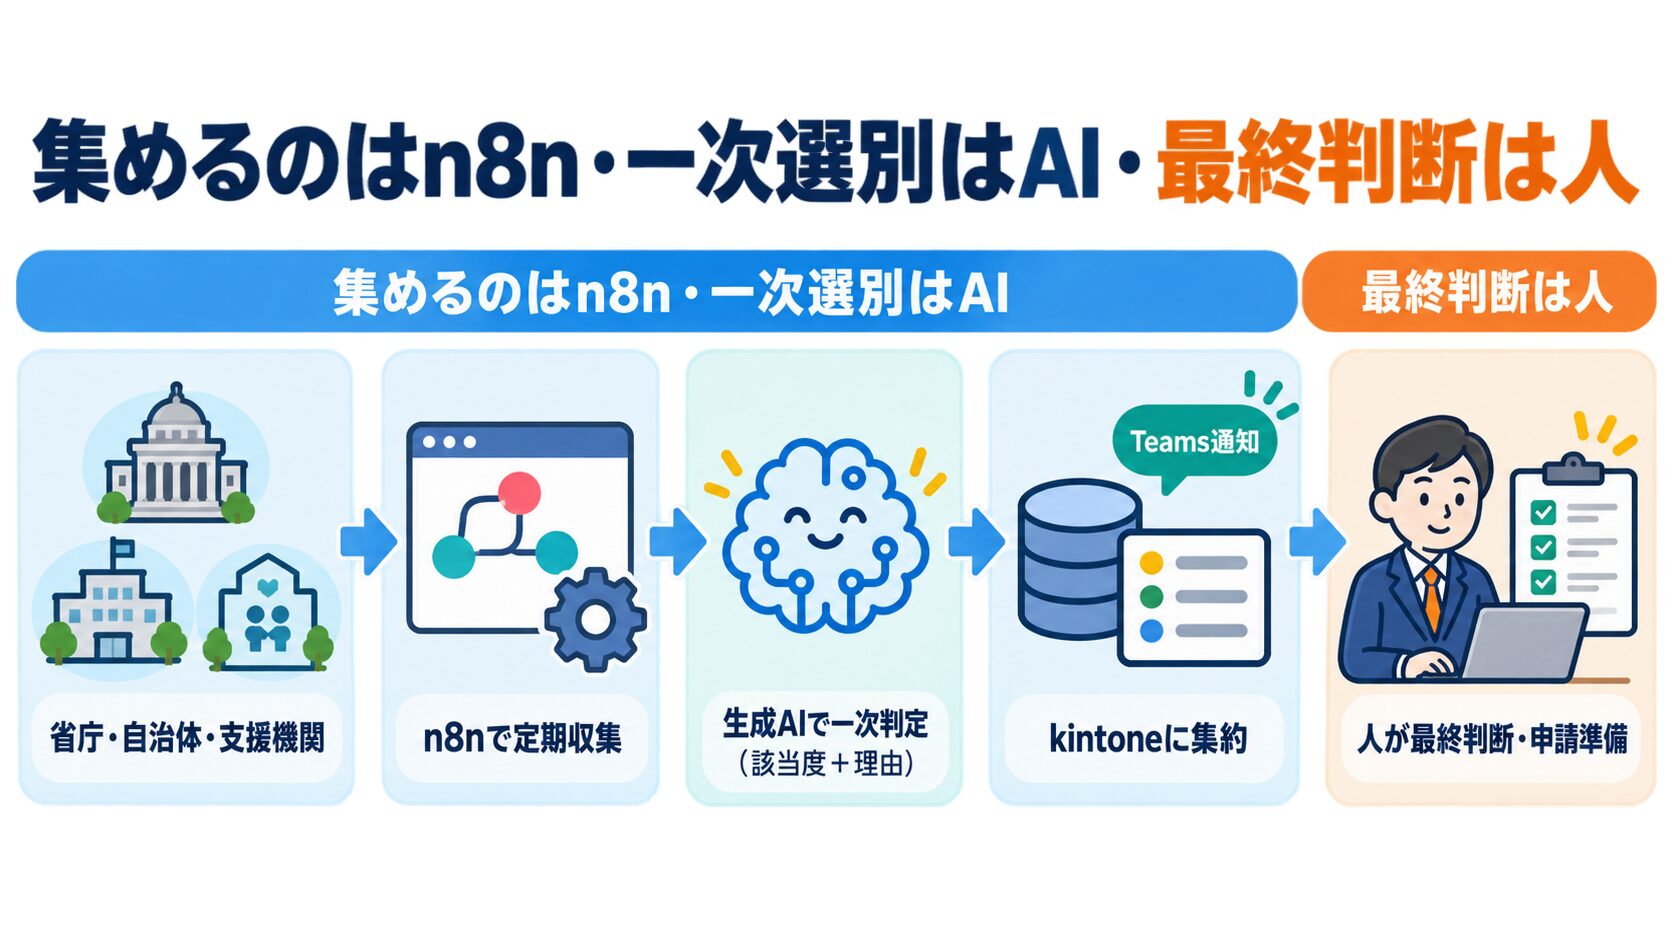
やり方の骨子は、役割を三つに分けることです。
まず、n8nという自動化ツールで公募情報を定期的に集めます。
次に、生成AIが自社の業種・規模・投資内容に照らして、該当しそうかを一次的に判定します。
そのうえで、該当度の高いものだけをkintoneの台帳に集約し、Teamsで担当者に知らせるという流れです。
勘所は「集めるのはn8n、一次選別はAI、最終判断は人」と、役割をはっきり分けることです。
この仕組みは、SIerに大きな開発を発注しなくても、いま使っているkintoneの延長で組めます。
費用の桁感も小さく、n8nはクラウド版なら年間契約でおおむね月数千円台から始められます(最新の料金はn8n公式の料金ページで確認してください)。
生成AIの判定にかかる費用も、従量課金のため公募1件あたりの単価は小さく抑えられます。
なぜ「集める」より「選別」が壁になるのか、どこでつまずきやすいのかを、このあと順番に説明します。
集めるだけでは回らない。選別の工程に手が回らないから
補助金を取りこぼす原因は、担当者の怠慢ではありません。
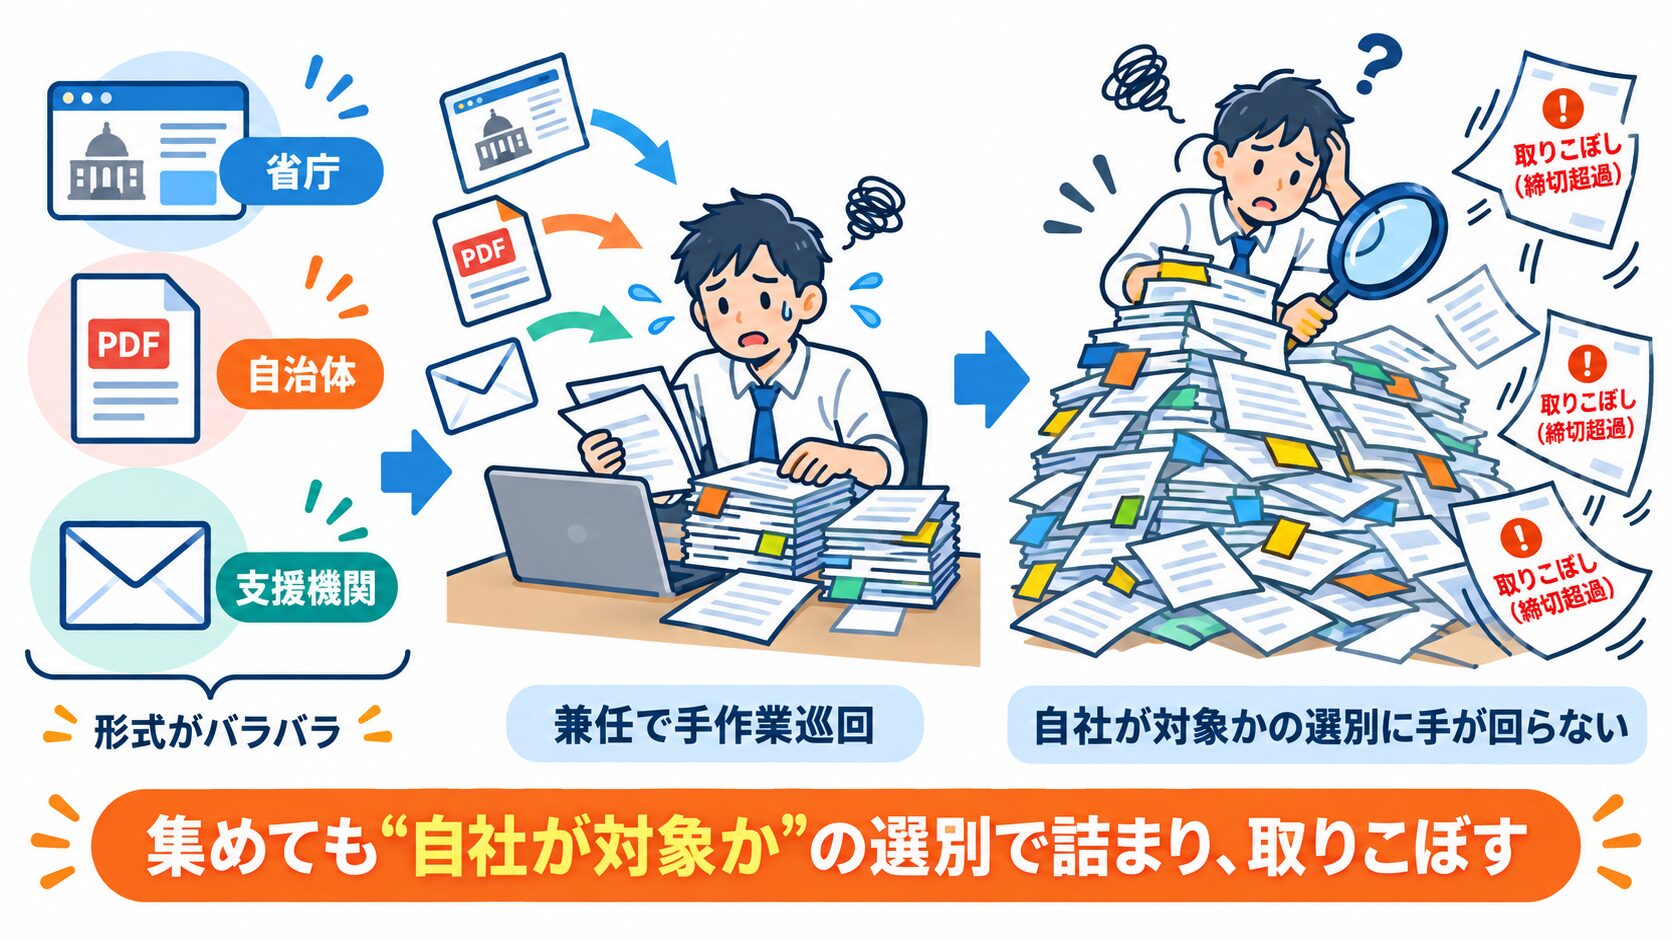
散らばった情報を兼任の担当者が手作業で追いかけ、しかも集めた後の選別まで手が回らないことが原因です。
補助金の情報源は、省庁・自治体・商工会議所などの支援機関に分かれ、形式もHTMLのお知らせ、PDFの募集要項、メールでの案内とバラバラです。
中小企業では、総務や経営企画がこうした巡回を兼任で担うことも珍しくありません。
日々の別業務が忙しくなれば、巡回そのものが後回しになります。
さらに、たとえ集められたとしても、大量の公募から「自社が対象になりそうか」を一件ずつ読んで判断する工程には、なかなか手が回りません。
情報収集を担当者に任せていても、自社が対象になり得た公募だったのかは、締切が近づくまで判然としないのです。
この選別の手詰まりこそが、取りこぼしの本当の温床になります。
補助金は設備投資や省力化の原資であり、一件の取りこぼしは、そのまま得られたはずの投資原資を失うことにほかなりません。
決裁者の立場で費用対効果を考えるなら、専用の補助金管理ツールを新たに導入する方法もあります。
一方で、いま使っているkintoneの上に選別の仕組みをAIで足す方法なら、既存の資産を活かせます。
どちらが自社に合うかは、扱う補助金の種類や件数によって変わるため、手間とコストの両面で比べて選ぶとよいでしょう。
なお、この仕組みの実装ハードルは、専用システムの開発より大きく下がります。
ただし、社内で構築や運用にあてる時間を確保できるかどうかは、技術的な可否とは別の問題として切り分けて考える必要があります。
集めるほど埋もれる。“全部集める”だけでは見落としは減らない
ある中小企業では、担当者がメルマガの購読とサイトの巡回を手作業で続けていました。
巡回は月に一度できればよいほうで、繁忙期に入るとそれも止まります。
その間に、要件に合う公募の締切を過ぎてしまい、あとからその存在に気づきます。
情報は「あるのに拾えていない」状態でした。
こうした失敗の裏には、いくつかの共通したつまずきがあります。
順番に見ていきましょう。
情報源ごとに形式がバラバラで、集める仕組みを作り込みすぎると破綻する
最初のつまずきは、「まずは全部自動で集めよう」と、あらゆる情報源からの収集を一度に作り込んでしまうことです。
前述のとおり、公募情報はHTML・PDF・メールと形式がバラバラです。
すべてを完璧に自動収集しようとすると、情報源ごとに個別の作り込みが必要になり、仕組みが膨れ上がって途中で頓挫します。
まずは効果の高い主要な情報源をいくつかに絞り、定期取得から始めるのが現実的です。
全部集めても、自社に関係あるかを人が読み切れず結局埋もれる
次のつまずきは、集めた後に待っています。
集まる公募の件数は多く、兼任の担当者が一件ずつ要件を読んで自社に該当するかを判断しきれません。
結局、大量の情報のなかに自社向けの公募が埋もれてしまいます。
つまり、集めること自体は解決になりません。
本当に効くのは、集めた後の「自社に関係あるか」の選別なのです。
AIの該当判定を鵜呑みにして自動で振り分けると、取りこぼし・無駄工数が出る
三つ目のつまずきは、「それなら選別もAIに任せて全自動にすればいい」と考えることです。
生成AIは文章の読み取りに強い一方で、補助金の募集要件のように条件が入り組んだ文章では、対象・対象外をしっかり読み分けられないことがあります。
対象業種の限定、投資額の下限、申請者の規模要件などが複雑に絡むと、該当を非該当と読み違えたり、条件を取りこぼしたりする余地が残るのです。
生成AIに文書を読ませて判断させるときの限界と付き合い方は、kintoneユーザーのための生成AI実践大全でも解説しています。
AIの判定を確定とみなして自動で振り分けてしまうと、本来は該当していた公募を切り捨てたり、逆に無関係な公募の対応に時間を取られたりします。
だからこそ、判定はあくまで「一次」にとどめ、最終的な要否は人が見極める設計にするわけです。
「集めるのはn8n・一次選別はAI・最終判断は人」に分ける
三つのつまずきは、役割を分けることで一つずつ解消できます。
全体像は、下の画面のようにn8nの1本のパイプラインで組みます。左の定時実行から、収集・一次判定・台帳への集約・通知まで一続きです。
<—①:n8nワークフロー全体(毎朝の定時実行→既存台帳・自社プロフィール取得→主要ポータルのRSS収集→正規化→新着抽出→生成AIで一次判定→整形→「台帳に全件登録」と「該当度A・Bだけ通知」への分岐が、1本のパイプラインで緑チェックで成功している引きの画面)—>
n8nで主要な情報源から定期的に集める(まず数個から)
はじめに、省庁・自治体・支援機関のうち、自社に関係の深い主要な情報源をいくつか選びます。
先に挙げたミラサポplusやJ-NET21などは、公募情報がまとまっている代表的なポータルです。
これらをn8nで定期的に巡回させ、新しい公募をRSSやメールの取り込みで自動的に集めます。
実際に動かすと、下の画面のように、主要ポータルから集めた公募が一覧の形にそろいます。ここまでが「集める」工程です。
<—②:n8nの「収集結果をまとめて正規化」ノードの出力(主要ポータルA・Bから集めた公募が、公募名・公募元・概要・URL・取得日の形で一覧にそろっている画面。ここまでが「集める」工程)—>
全網羅を狙わず、効果の高い数個から始めて、運用しながら広げるのが無理のない進め方です。
生成AIは“自社が対象になりそうか”の一次判定に絞り、判定理由も残す
集めた公募は、そのまま台帳に流し込むのではなく、生成AIにかけます。
自社の業種・規模・投資内容をあらかじめAIに渡しておき、各公募について「自社が対象になりそうか」を一次的に判定させます。
その判断材料として、自社の情報はkintoneに下の画面のように持たせておきます。
<—③:kintoneの自社プロフィールマスタのレコード(業種・従業員数・所在地・投資計画・除外テーマが入り、AIに渡す判断材料であることが分かる画面)—>
ここで大切なのは、最終的な確定判断を人に委ねることです。
AIには「該当度(AIが見立てた一致の度合い)」と、そう判断した理由をセットで出させ、kintoneの台帳に記録します。
すると生成AIは、下の画面のように公募ごとに該当度・該当スコア・判定理由をまとめて返します。
<—④:n8nの「生成AIで自社該当を一次判定」ノードの出力(公募ごとに該当度〔A/B/C〕・該当スコア・判定理由がセットで返っている画面)—>
AIの役割は、人が確認すべき候補を絞り込むところまでと割り切ります。
判定理由が残っていれば、あとから人が確認するとき、なぜその公募が挙がったのかをすぐ把握できるはずです。
該当度の高い公募だけをkintoneに集約し、Teamsで知らせて人が最終判断する
最後に、該当度の高い公募だけをkintoneの台帳に集約し、Teamsで担当者に通知します。
下の画面が、該当度の高い公募が判定理由つきで集約された台帳です。
<—⑤:kintoneの補助金公募台帳のレコード一覧(該当度A・Bの公募が判定理由・確認ステータスつきで集約され、該当度でソート/絞り込みされている画面)—>
担当者は、大量の情報源を巡回する代わりに、AIが絞り込んだ候補と判定理由に目を通します。
そして担当者には、下の画面のように該当度の高い公募だけがTeamsに届きます。
<—⑥:Teamsに届いた通知の画面(該当度A・Bの公募だけが、判定理由と「AIの一次判定です/申請要否は人が確認」の但し書きつきで届いている構図)—>
そのうえで注力するのは、申請するかどうかの最終判断と、実際の申請準備です。
担当者が確認するのは、下の画面のような1件のレコードです。確認ステータスが「未確認」のまま届き、内容と判定理由を見て、申請するかどうかを判断します。
<—⑦:kintoneの補助金公募台帳の1レコード詳細(該当度A・確認ステータスが「未確認」で、AIの判定理由が入り、人がこれを見て申請要否を判断する画面)—>
集めて絞り込むところまではn8nと生成AIに任せ、最終的な判断は人が担います。
この線引きが、すべてをAIに任せてしまう自動化との決定的な違いです。
“集める”から“選別されて届く”へ変わる
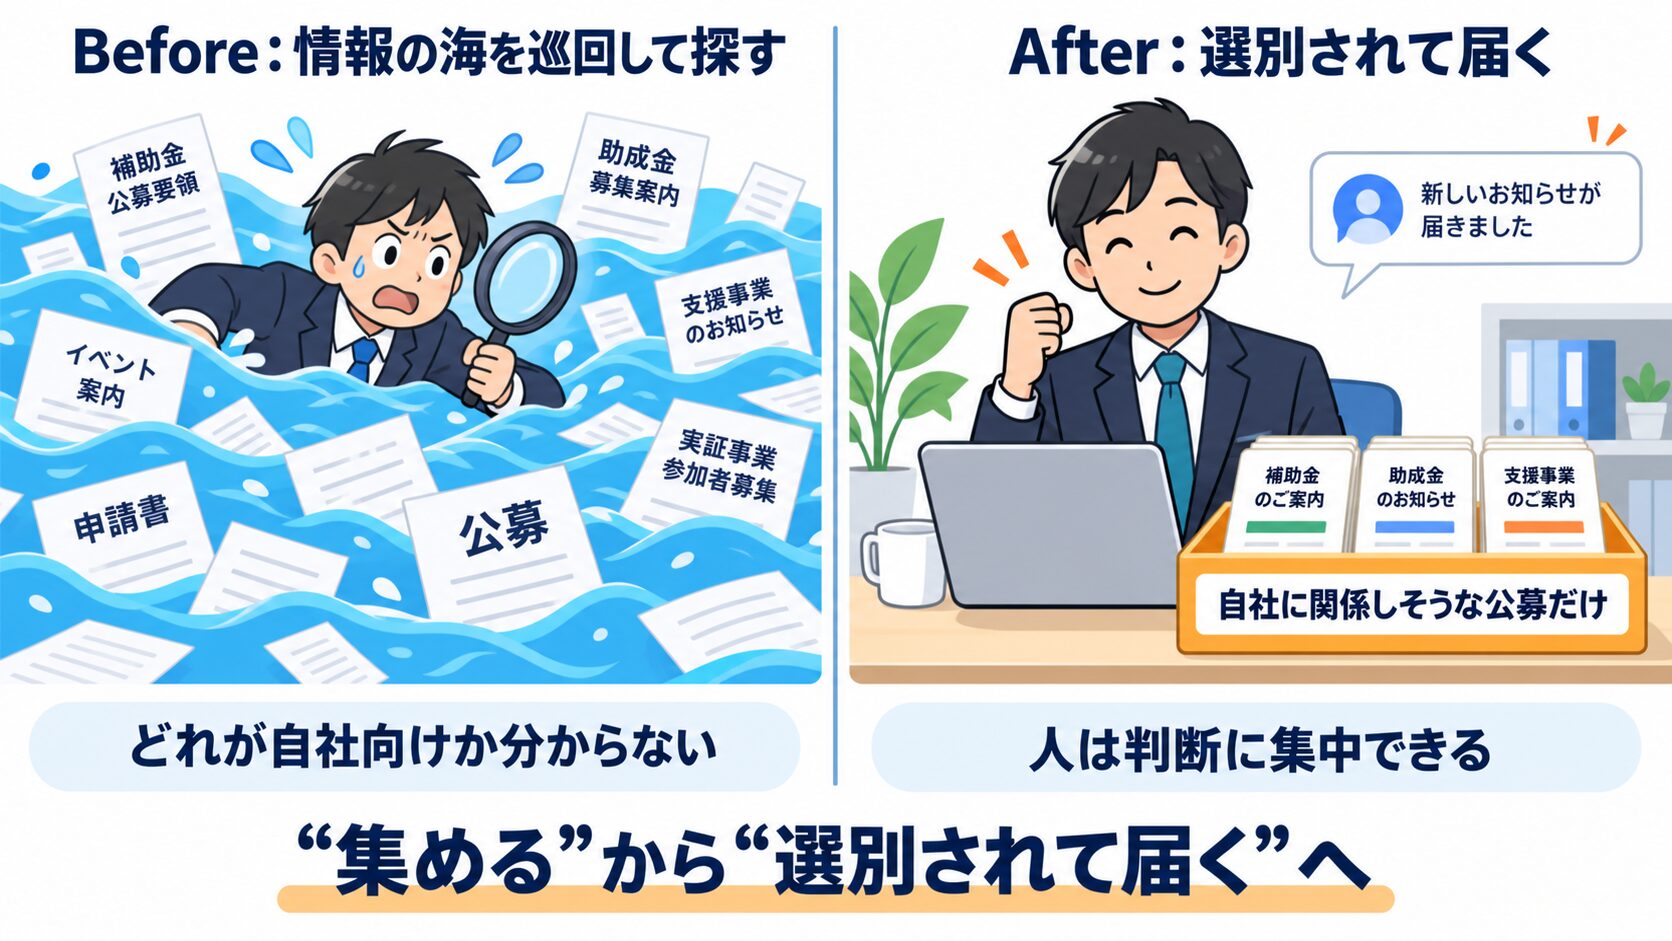
仕組みが一通り整うと、補助金の探し方の景色が変わります。
情報の海から自社向けの公募を探していた状態から、自社に関係しそうな公募だけが手元に届く状態へと変わるのです。
担当者の仕事は、あちこちを巡回して集めることではなく、届いた候補を確認して判断することになります。
巡回に費やしていた時間が、そのまま「判断に充てる時間」に置き換わるわけです。
そして、つまずきやすい場所は、次の三つだと分かっています。
- あらゆる情報源を一度に自動収集しようとして、作り込みが破綻すること
- 集めるだけで、自社に関係あるかの選別に手が回らないこと
- AIの一次判定を確定とみなして、人の確認を挟まずに振り分けること
この三か所を先に押さえておけば、SIerに大きな開発を発注しなくても、kintoneの延長で自社に合った仕組みを組めます。
技術的な実現可能性と、社内で運用の時間を確保できるかは、切り分けて考えるべき別問題です。この切り分けさえできていれば、着手のハードルはぐっと下がります。
まとめ
補助金を取りこぼす本当の原因は、情報を集めきれないことよりも、集めた後に「自社が対象か」を選別する工程に手が回らないことにあります。
だからこそ、公募情報を集めるのはn8n、自社が対象になりそうかの一次選別は生成AI、そして最終判断は人、と役割を分けるわけです。
この「集めるのはn8n・一次選別はAI・最終判断は人」という三分担なら、SIerに頼らず、兼任体制のまま補助金の見落としを防げます。
なお、具体的な補助金制度の要件や金額は、必ず公募元の情報を確認してください。この記事で示したのは、自社に関係しそうな公募を見落とさずに拾い上げるための、仕組みの考え方です。
最後に
自社がどの情報源を追うべきか、どんな基準で一次選別をかけるかは、業種や投資計画によって変わります。
「自社の場合はどう組めばいいのか」「そもそも自社で運用できるのか」で判断がつかない場合は、一度ご相談ください。
kintoneと生成AI、n8nを組み合わせた業務自動化について、ものづくりAI自動化ファクトリーの無料相談でお手伝いします。
関連記事
2026-09-14
契約管理の更新期限、見落としを防ぐには? kintone×n8n×生成AIで「期限抽出はAI・判断は人」に分ける方法
契約の更新期限、結局どうやって管理するのが正解なのか 取引基本契約、リース、サブスクリプション、賃貸借。 会社には種類の違う契約が次々に増え、契約管理は少しずつ複雑になっていきます。 契約書が部署ごとのフォルダやキャビネットに分かれて保管され、更新期限は担当者…
2026-09-13
問い合わせ管理システムを新しく契約する前に。kintoneとn8n・生成AIで、メール対応の属人化を解く
問い合わせメールの内容を読んで、担当者に振り分けて、一次返信を書く。この繰り返しに毎日追われ、問い合わせ管理システムの導入を考え始めた総務やカスタマーサポートの担当者もいるのではないでしょうか。専任の窓口を置けず、1〜2名が他の業務と兼務しながらこなしている中…
2026-09-12
kintoneの勤怠管理、打刻漏れの当日検知をn8nで自動化する方法を紹介
打刻漏れの当日検知は大がかりな開発だと思い込んでいないか kintoneで勤怠管理をしていても、月末の勤怠締めになると、打刻漏れがまとめて表に出てきます。出勤しているのに退勤の打刻がない人、そもそも出勤の打刻が抜けている人が、一覧にずらりと並ぶ状態です。 労務…