このテーマのまとめ:n8n入門 ›
kintoneでヒヤリハットの報告フォームを運用している製造現場は多いはずです。ところが、報告そのものは集まっても、その先の分類・集計になると話は別です。自由記述で書かれたヒヤリハットを、どうやって傾向として見える化するかで手が止まっている担当者は少なくないのではないでしょうか。
ヒヤリハットの集計・分類の自動化は、SIerに発注しないと無理なのか
ヒヤリハット報告フォームをkintoneで作り、件数自体は集まっています。そんな職場でも、報告が集まった先で止まっていることがあります。自由記述中心のフォームなので、分類・集計は毎回手作業になり、結局は後回しにされてしまうのです。
安全衛生の担当者は、生産管理や品質管理と兼任していることも珍しくありません。月次の安全衛生委員会が近づくと、溜まった自由記述をまとめて目視で分類しようとします。ところが件数が多いうえに、書き手によって表現がバラバラなため、時間内に終わらせられず、後回しにされがちです。
委員会で「傾向は特にありません」と報告すれば、上司から「本当に傾向がないのか、ちゃんと見ているのか」と問われかねません。
この状態を変えようとして、「ヒヤリハットの傾向を分析し、システム化する」と考えたとたん、身構えてしまう担当者は多いでしょう。傾向分析のシステム化と聞くと、SIerに発注する大がかりな開発案件を連想してしまいがちだからです。
要件定義から始まり、見積もりを取り、社内の決裁を通し、開発期間を待ちます。そんなプロセスを思い浮かべると、二の足を踏んでしまうのも無理はありません。
しかし、実際にこの仕組みを組んでみると、この思い込みは崩れます。分類・集計を自動化するために必要だったのは、大がかりなシステム開発ではなく、n8nと生成AIを使った仕組みでした。
n8nと生成AIを挟めば、自由記述のヒヤリハットも分類軸付きでkintoneに溜まっていく
先に結論からお伝えすると、これは自社の検証環境で組んだ仕組みです。顧客の本番環境で稼働させた実績ではなく、あくまで自社の検証環境で組んだ仕組みであることを、最初にお断りしておきます。
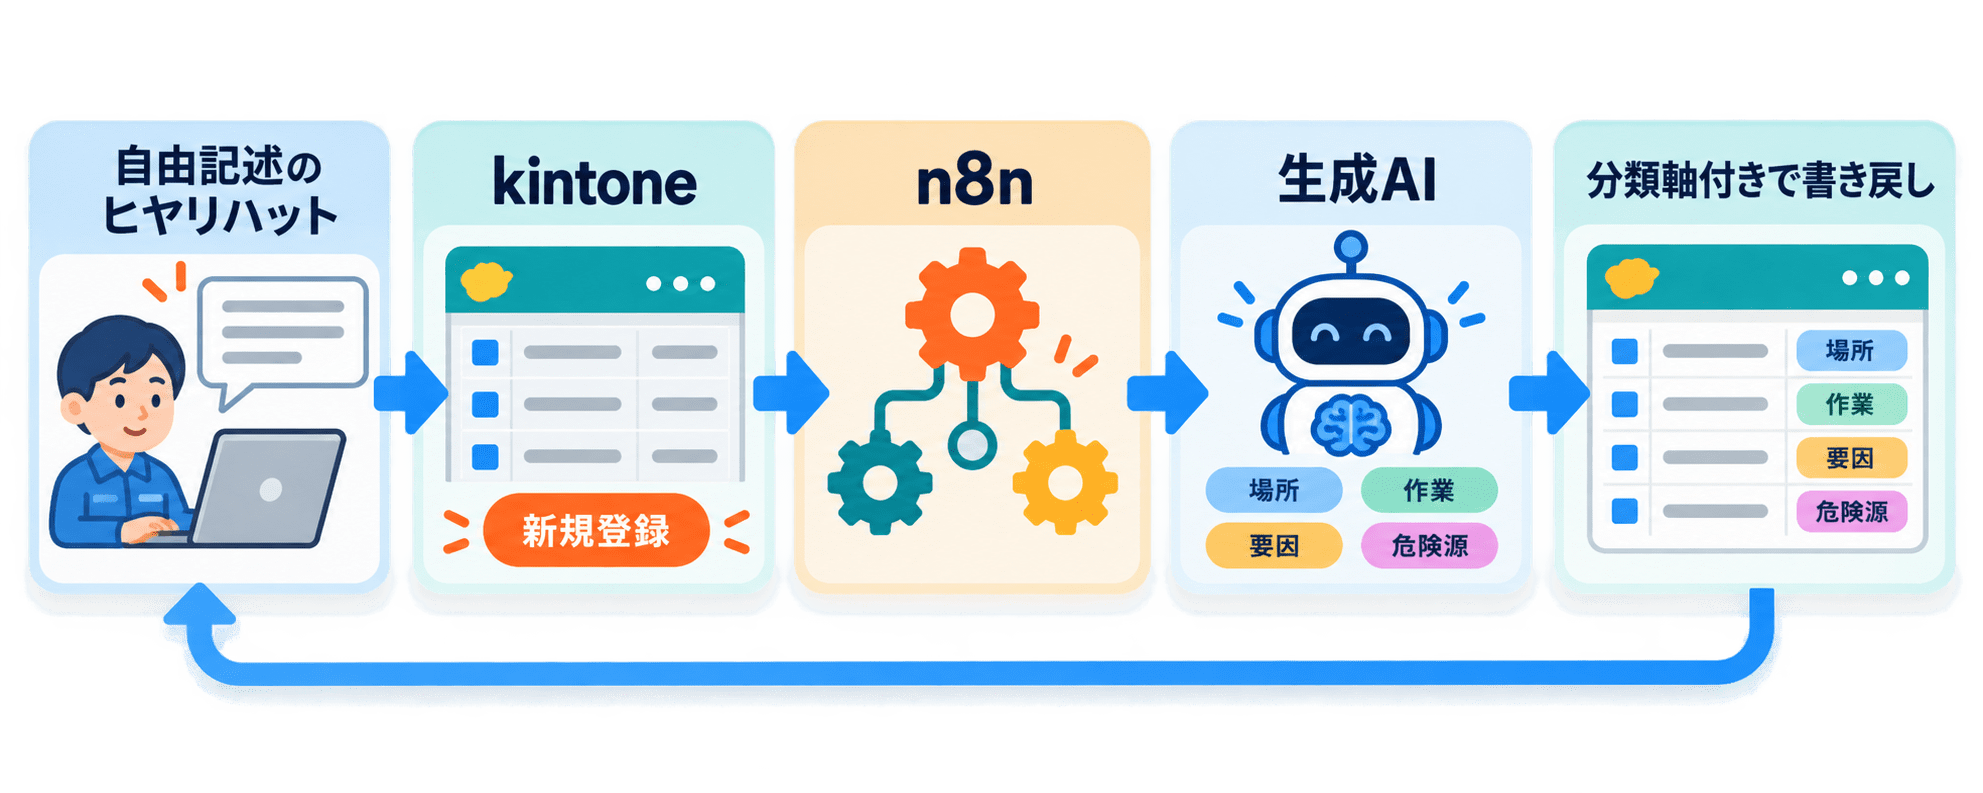
到達点はこうです。kintoneに新規のヒヤリハットが自由記述のまま登録されると、n8nがそのレコードを検知し、生成AIに渡します。
生成AIは「場所」「作業」「要因」「危険源」という4つの分類軸のどれに当てはまるかを判定し、kintoneのREST API経由でその結果をレコードに書き戻します。担当者が何かを手動で分類する前に、レコードにはすでに分類軸が付いている状態です。
新規のヒヤリハットが登録された都度、自動で分類が完了する状態を実現しました。しかも、担当者が実際に目を通すのは全件ではありません。生成AIが「この分類には自信がない」と判断したものだけです。全件を目視していた状態から、確信度の低い一部だけを確認する状態に変わります。
私たちがこの記事で伝えたい核心は、次の一点です。ヒヤリハットが活きないのは、報告数が足りないからではありません。溜まった自由記述を、人手で分類・集計できていないことが問題なのです。 分類を生成AIに任せれば、SIerに大がかりな開発を発注せずとも、傾向は見えるようになります。
ただし、生成AIが出した分類結果を、そのまま無条件に確定させているわけではありません。なぜ候補提示という一手間を挟む設計にしたのか、その理由は後ほどお伝えします。
後回しになるのは、分類作業が担当者の感覚頼みだから
なぜ、ヒヤリハットの分類・集計はここまで後回しにされてしまうのでしょうか。その原因は、技術的な難しさではなく、分類作業そのものが担当者個人の感覚に依存しがちな運用になっていることにあります。
これは、生産計画・工程管理の現場でよく聞かれる「計画は基本的に担当者の感覚で立てているのが現状」という属人化の構造と、根っこは同じです。
安全衛生の担当者は、多くの場合、専任ではなく兼任です。生産管理や品質管理など本来の業務を抱えながら、ヒヤリハットの分類・集計にも対応しなければなりません。
しかも、自由記述は書き手によって表現がバラバラです。「フォークリフトに轢かれそうになった」と書く人もいれば、「運搬車が急に近づいてきて危なかった」と書く人もいます。同じ種類の危険であっても、機械的なキーワード集計では拾いきれません。
結局、担当者は自由記述を1件ずつ読み、自分の感覚で「これは作業に関するものか、設備に関するものか」を判断していくしかなくなります。件数が多くなるほど、この作業は後回しにされがちです。「その人にしかわからない」分類基準のまま、属人的な運用が積み重なっていきます。
この分類ロジックをn8nと生成AIで組み込むこと自体は、kintoneのアプリ運用ができる担当者であれば手が届く範囲です。
n8nはクラウド版であれば月20ユーロ程度から利用できるプランがあり、SIerへの大規模発注に比べれば投資判断もしやすい規模です。
ただし、n8nでの分類フローの構築や、生成AIにわたすプロンプトの設計には、一定の学習コストがかかります。社内でその時間を確保できるかどうかは、また別の問題です。この点については、記事の最後で相談先を案内します。
AIに分類を任せたら、3つの理由でカテゴリがバラついた
「生成AIに投げれば、分類は一発で片付くだろう」。そう考えて着手したものの、実際に運用へ乗せる前の段階で、3つのつまずきに直面しました。踏んだ順に紹介します。
似た内容でも表現が違うと、別カテゴリに分類されてしまう
最初につまずいたのは、分類軸そのものを生成AIに自由に作らせたときでした。カテゴリを固定せず、「このヒヤリハットをいくつかのグループに分けてください」という指示だけを与えると、書き手ごとの言い回しの違いによって、同じ性質のヒヤリハットが異なるカテゴリに割り振られてしまったのです。
「フォークリフトに轢かれそうになった」と「運搬車が急に近づいてきて危なかった」は、どちらも運搬車両に関する危険であるにもかかわらず、生成AIの出力では別々のカテゴリとして扱われることがありました。
生成AIは意味を理解しているように見えても、カテゴリの粒度や境界線を毎回一貫させることは、指示を与えなければ苦手とする領域です。
OpenAIが公開するプロンプトエンジニアリングガイドでも、分類先の選択肢をあらかじめ例示することでモデルの出力が安定しやすくなる旨が示されています。
これは特定のモデルに限った話ではなく、事前にカテゴリを固定せずに自由分類をさせるタスク全般に共通する性質だといえます。
確信度の低い分類結果を、そのまま自動確定させると誤りが紛れ込む
次につまずいたのは、分類結果をそのままkintoneへ書き込む設計にしていたときです。生成AIは、判断に迷うようなケースでも、必ず何らかのカテゴリを1つ返します。
曖昧な自由記述であっても「たぶんこれだろう」という形で結果を出してしまうため、その結果を無条件に信用して確定させると、誤ったカテゴリのまま蓄積されてしまいます。
生成AIの出力は確率的に単語を選ぶ仕組みで動いており、OpenAIのAPIリファレンスが示す通り、同じ入力でも実行のたびに結果が変わりうる性質を持つのです。判断の迷いが確信度という形で表に出てくるのは、この性質の裏返しといえます。
厄介なのは、誤分類に気づくタイミングです。誤ったカテゴリのまま集計が進んでしまうと、あとから傾向を確認した担当者が、実際には起きていない偏りを「傾向」として誤って報告しかねません。分類は自動化できても、確信度の低い判断まで機械に丸投げしてよいわけではないと痛感しました。
過去に溜まった自由記述を一括で分類し直そうとすると、基準が途中でブレる
3つ目のつまずきは、過去に溜まっていた自由記述をまとめて一括処理しようとしたときに起きました。件数が多いため、一度に大量のレコードを生成AIに渡して処理しようとしたところ、処理が進むにつれて分類の基準が少しずつずれていく現象が見られたのです。
これも、生成AIの出力が確率的に決まる性質による影響だと考えられます。1件ずつ独立して判定させているつもりでも、大量に連続処理すると、揺らぎが積み重なって基準のブレとして現れやすくなります。
序盤に「作業要因」として分類されていたような内容が、終盤では「設備要因」として分類されるなど、同じ性質の記述であっても、処理する順番によって結果が変わってしまうことがありました。過去分をまとめて片付けようとする発想自体が、この基準のブレを招く原因になっていたのです。
バラつきを抑えるために変えた3つの設計
3つのつまずきを踏まえてたどり着いたのは、生成AIに「自由に考えさせる」のではなく、「決められた枠のなかで判断させる」という設計でした。ここで押さえた設計は、単に投げれば一発で終わると思っていた分類作業を、自社の手で運用できる形に落とし込むための工夫そのものです。
分類軸は生成AIに任せず、場所・作業・要因・危険源の4カテゴリで固定する
1つ目のつまずき(表現の違いによるカテゴリのバラつき)への対策は、分類軸そのものを事前に固定することでした。
生成AIにカテゴリ自体を作らせるのではなく、「場所」「作業」「要因」「危険源」という4つのカテゴリをあらかじめ用意し、生成AIには「このヒヤリハットはどのカテゴリに当てはまるか」だけを判定させる設計に変えました。
カテゴリの器が固定されていれば、書き手の言い回しが多少違っても、生成AIは同じ器に振り分けます。「フォークリフトに轢かれそうになった」も「運搬車が急に近づいてきて危なかった」も、どちらも「危険源:運搬車両」という同じカテゴリに収まるようになりました。
確信度が一定を下回った分類は、自動確定せず候補として担当者に提示する
2つ目のつまずき(確信度の低い分類の自動確定)への対策は、候補提示型の設計です。生成AIに分類結果と一緒に確信度も出力させ、確信度が一定の水準を下回った場合は、kintoneのレコードを自動確定させず、担当者への確認候補として残すようにしました。
この設計によって、担当者の確認作業は「全件を目視する」から「怪しいものだけを確認する」に変わります。生成AIが自信を持って判定した分類はそのまま確定し、判断に迷ったものだけを担当者が最終確認します。 この役割分担が、確信度の低い分類結果を無条件に確定させてしまうリスクを抑えているのです。
過去分の一括処理はせず、運用開始日以降の新規レコードから始める
3つ目のつまずき(一括処理による基準のブレ)への対策は、過去分を無理に遡って処理しないという判断です。過去に溜まっていた自由記述はそのまま残し、運用を開始した日以降に新しく登録されるレコードから、段階的に分類データを蓄積していく方針に変えました。
一度に大量のレコードを処理しようとするから基準がブレるのであれば、そもそも一括処理という発想自体をやめてしまえばよい、という考え方です。新規登録分だけを対象にすることで、分類の基準を安定させたまま運用を続けられるようになりました。
これら3つの設計を経て見えてきたのは、「生成AIに投げれば一発で終わる」という発想そのものが、そもそも成立しないということです。分類軸を固定し、確信度で線引きし、対象範囲を絞る。この3つの設計判断こそが、自由記述の分類を自社の手で回せる仕組みに変える肝でした。
分類され構造化されたヒヤリハットが、傾向把握の土台になる
自由記述のまま溜まっているうちは、ヒヤリハットは「報告した」という記録で終わってしまいます。誰かが読み返さない限り、そこに何の傾向があるのかは分かりません。
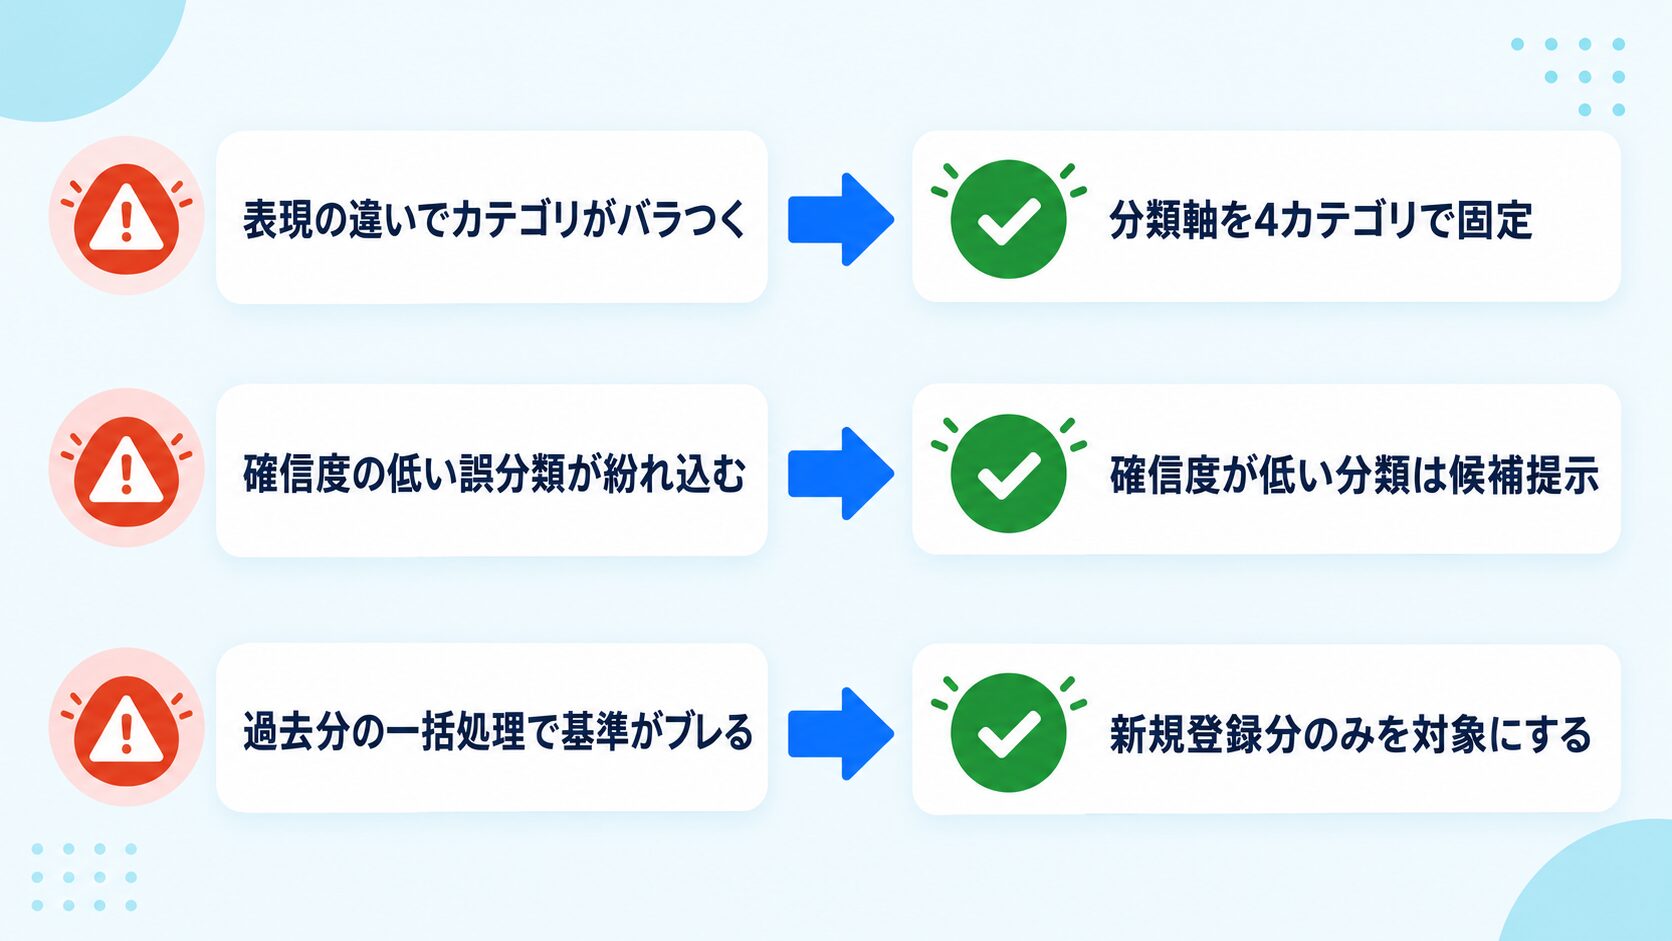
分類軸が付与され、構造化されたデータとしてkintoneに蓄積されるようになると、状況は変わります。場所別、作業別、要因別に件数を集計できるようになり、「特定の作業で危険源が繰り返し発生している」といった傾向を、担当者が目視で読み返さなくても把握できる状態になるのです。
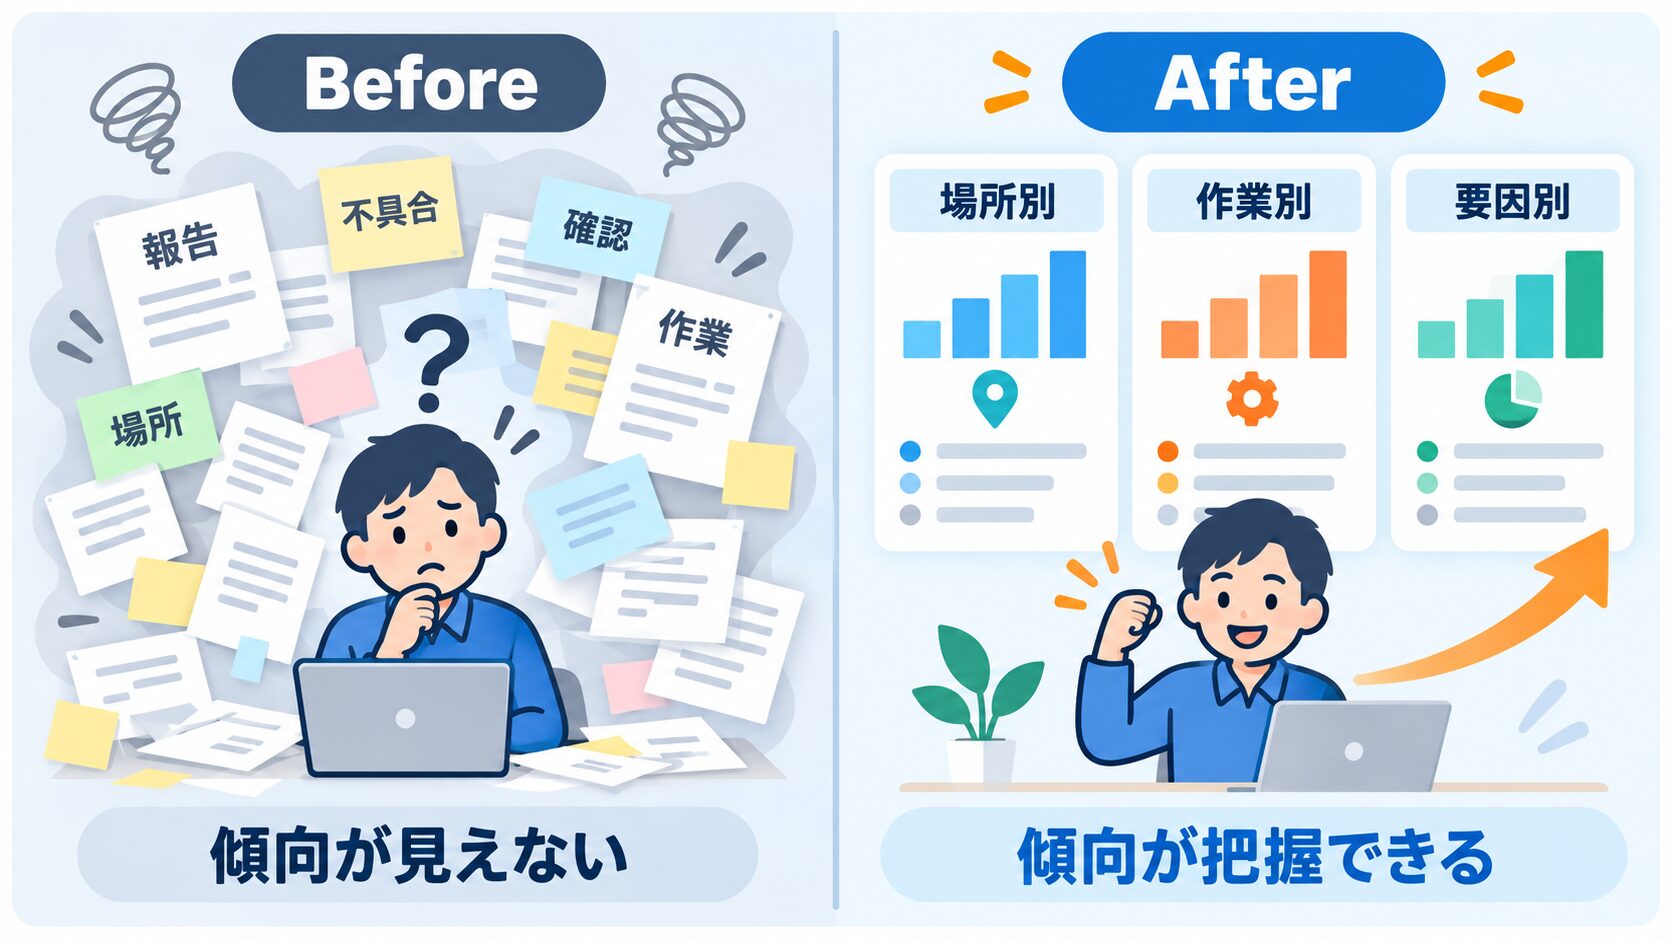
詰まる場所は、すでに3か所と分かっています。表現のバラつき、確信度の低い分類の扱い、そして過去分の一括処理です。この3か所さえ押さえれば、自社の手で分類・集計の仕組みを組めます。
SIerに発注しないと無理だと思われがちなこの領域も、実際には分類軸の設計さえ押さえれば、決して大がかりな開発を必要としません。
ただし、n8nでの分類フローの構築や生成AIのプロンプト設計を、実際に誰が担当するのかは別問題です。技術的に組める仕組みであることと、社内でその作業に取り組む時間を確保できるかどうかは、切り分けて考える必要があります。
まとめ
ヒヤリハットが活きないのは、報告数が足りないからではありません。溜まった自由記述を人手で分類・集計できていないことが本当の課題です。n8nと生成AIを使い、分類軸を固定した上で確信度に応じて候補提示する設計にすれば、SIerに大がかりな開発を発注せずとも、自社の手で安全衛生の傾向を見える化できます。
最後に
ここで紹介した設計は、あくまで自社の検証環境で組んだものです。実際にどこで詰まり、どんな設計が必要になるかは、既存のkintoneアプリの構成や自由記述の書かれ方によって変わります。
自社の環境でどこから手をつければよいか判断がつかない場合は、ものづくりAI自動化ファクトリーの無料相談をご利用ください。生成AIとkintoneを組み合わせた自動化について、貴社の状況に応じてご相談いただけます。
生成AIとkintoneの連携をより幅広く知りたい方は、kintoneユーザーのための生成AI実践大全もあわせてご覧ください。
社内の問い合わせ対応をkintoneと生成AIで効率化した事例は、kintoneデータを参照し、綺麗な文章で回答。kintone×n8n×生成AIで社内問い合わせを効率化するワークフローで紹介しています。
関連記事
-
2026-10-29
Excelで作ったスキルマップ、更新が追いついていますか|製造業でkintone×n8nで最新に保つ
Excelでスキル一覧は作ったものの、更新が追いつかなくなってきた 多能工化を進めてきた製造業では、「誰がどの工程をできるか」を一覧にしたスキルマップ(多能工表とも呼ばれます)を、Excelで作っている現場は珍しくありません。作った当初は、現場の実態をそのまま…
-
2026-10-28
kintoneワークフローはSlackの承認を「非公式」として拾えない。n8nで正式な記録に残す
Slackでの「これOKですか」は、非公式な確認だから記録に残らなくて当然なのでしょうか Slackが社内に根づいている会社では、申請や承認の多くがチャットの一言で済んでいきます。 kintoneでワークフロー(プロセス管理)を組んでいる会社でも、こうしたSl…
-
2026-10-27
Chatworkのやりとりを手で転記しない。kintone Chatwork連携でメッセージから直接レコードを作る
Chatworkで受けた依頼、結局あとでkintoneに手で打ち直していませんか 営業や業務の連絡をChatworkに集めている会社なら、お客さまからの依頼も社内での決定事項も、まずはChatworkのルームに流れてきます。そして、その内容をあとで誰かがkin…